Skeletal samples
Os
restos mortais coletados neste estudo estão sob a guarda do Museu
Nacional do Quênia (Kisese II), do Museu Nacional da Tanzânia
(Mlambalasi), do Departamento de Museus e Monumentos do Malawi (Hora 1 e
Fingira) e do Museu Livingstone (Kalemba). As permissões e os
protocolos de coleta de amostras estão descritos na Nota Suplementar 3.
Os indivíduos foram selecionados com base em seus contextos
arqueológicos da Idade da Pedra Recente, e as amostras de esqueletos
foram escolhidas para maximizar a probabilidade de obtenção de DNA
antigo autêntico e minimizar danos. A falange de Fingira foi um achado
isolado em um contexto de escavação mista e era pequena demais para
fornecer DNA antigo e datação direta. Uma lista das amostras
bem-sucedidas e das que não foram obtidas está disponível na Tabela
Suplementar 1.
A datação direta por radiocarbono foi tentada em cinco dos seis
indivíduos bem-sucedidos no Laboratório de Radiocarbono da Universidade
Estadual da Pensilvânia, utilizando métodos estabelecidos e medidas de
controle de qualidade para purificação de colágeno. 43,44antes da análise por espectrometria de massa com acelerador (Nota Suplementar 4
). Uma lista das datas diretas e dos resultados de isótopos estáveis
para os dois indivíduos datados com sucesso, e datas indiretas, quando
disponíveis, para os demais indivíduos, é fornecida nas Tabelas
Suplementares 3 e 4. Todas as datas foram calibradas usando o OxCal (v.4.4). 45 , com uma distribuição a priori uniforme (U(0,100)) para modelar uma mistura de duas curvas: IntCal20 (ref. 46 ) e SHCal20 (ref. 47 ).
trabalho de laboratório de DNA
Geramos
com sucesso dados de DNA antigo (aDNA) em todo o genoma a partir de um
total de seis elementos esqueléticos humanos: cinco ossos petrosos e uma
falange. Processamos outros seis ossos petrosos, oito dentes e 11
outros ossos da mesma maneira, mas não obtivemos DNA utilizável (Tabela
Suplementar 1
). Em instalações de sala limpa na Harvard Medical School, limpamos as
superfícies externas das amostras e, em seguida, realizamos jateamento
de areia (ossos petrosos). 48 ou
perfurados (outros ossos e dentes) para obtenção de pó (informações
adicionais para as 15 amostras previamente publicadas relatadas aqui com
maior abrangência podem ser encontradas nas referências). 11 , 13 , 15 , 16 Extraímos o DNA. 49 , 50 , 51 e
prepararam bibliotecas de sequenciamento com código de barras (entre
uma e seis bibliotecas para os seis indivíduos recém-relatados e entre
uma e oito bibliotecas adicionais para os indivíduos relatados
anteriormente): da Caverna Mota, na Etiópia. 15 (I5950); White Rock Point no Quênia 13 (I8930); Caverna Gishimangeda na Tanzânia 13 (I13763, I13982 e I13983); Chencherere II (I4421 e I4422), Fingira (I4426, I4427 e I4468) e Hora 1 (I2967) no Malawi 11 ; e Shum Laka em Camarões 16 (I10871,
I10872, I10873 e I10874), tratando em quase todos os casos com
uracil-DNA-glicosilase (UDG) para reduzir artefatos de danos ao DNA
antigo. 52,53,54.
We used two rounds of targeted in-solution hybridization to enrich the
libraries for molecules from the mitochondrial genome and overlapping a
set of around 1.2 million nuclear SNPs55,56,57,58e
sequenciadas em pools nas máquinas Illumina NextSeq 500 e HiSeqX10 com
leituras pareadas de 76 pb ou 101 pb. Mais detalhes sobre cada
biblioteca são fornecidos na Tabela Suplementar 2.
Para o indivíduo Mota (I5950), também geramos dados de sequenciamento
shotgun de genoma completo, usando a mesma biblioteca (pré-enriquecida),
com sete canais com leituras pareadas de 101 pb (em máquinas Illumina
HiSeq X Ten), resultando em uma cobertura de aproximadamente 26×
(1.176.635 sítios cobertos a partir do conjunto de SNPs de captura).
Bioinformatics procedures
A
partir dos dados brutos de sequenciamento, utilizamos informações de
código de barras para atribuir as leituras às bibliotecas apropriadas
(permitindo no máximo uma incompatibilidade por par de leituras). Unimos
as leituras sobrepostas (com pelo menos 15 bases), removemos as
sequências de código de barras e adaptadores das extremidades e mapeamos
para o genoma de referência do mtDNA RSRS. 59e o genoma de referência humano hg19 usando BWA (v.0.6.1) 60 Após
o alinhamento, removemos as leituras duplicadas e as leituras com
qualidade de mapeamento inferior a 10 (30 para dados de sequenciamento
shotgun) ou com comprimento inferior a 30 bases. Para preparar os dados
para análise, descartamos as bases terminais das leituras (2 para
bibliotecas tratadas com UDG e 5 para não tratadas, para eliminar a
maioria dos erros induzidos por danos), mesclamos os arquivos .bam de
todas as bibliotecas de cada indivíduo e determinamos os genótipos
pseudohaploides (um alelo escolhido aleatoriamente entre as leituras
alinhadas em cada SNP). A alta cobertura dos dados de sequenciamento
shotgun do genoma completo de Mota nos permitiu determinar os genótipos
diploides; utilizamos o procedimento da referência [inserir número da
referência]. 26 ,
incluindo o armazenamento dos genótipos em um formato estilo FASTA, que
é facilmente acessível através dos softwares cascertain e cTools. O
código para as ferramentas de bioinformática e fluxos de trabalho de
dados está disponível no GitHub ( https://github.com/DReichLab/ADNA-Tools e https://github.com/DReichLab/adna-workflow ).
Marcadores uniparentais e autenticação
Determinamos o sexo genético de cada indivíduo de acordo com a proporção de fragmentos de DNA mapeados nos cromossomos X e Y. 61 . Identificamos os haplogrupos do mtDNA usando o HaploGrep2 (ref. 62 ), comparando posições informativas com PhyloTree Build 17 (ref. 63 (Tabela Suplementar 6
). Para quatro indivíduos (I2967, I4422, I4426 e I19528) com evidências
de haplogrupos que se dividiram parcialmente, mas não completamente, ao
longo de linhagens mais específicas, usamos a notação [chamada
HaploGrep2]/[direção do subclado] (por exemplo, L0f/L0f3 para uma
divisão na linhagem que leva a L0f3, mas não dentro de L0f3). Para os
homens, identificamos os haplogrupos do cromossomo Y comparando suas
mutações derivadas com a filogenia do cromossomo Y fornecida pelo YFull (
https://yfull.com ).
We
evaluated the authenticity of the data first by measuring the rate of
characteristic aDNA damage-induced errors at the ends of sequenced
molecules. We next searched directly for possible contamination by
examining (1) the X/Y ratio mentioned above (in case of contamination by
sequences from the opposite sex), (2) the consistency of mtDNA-mapped
sequences with the haplogroup call for each individual64 and (3) the heterozygosity rate at variable sites on the X chromosome (for males only)65Dois
indivíduos (I2966 de Hora 1 e I13763 da Caverna Gishimangeda)
apresentaram evidências não negligenciáveis de contaminação a partir
dessas métricas e também demonstraram compartilhamento excessivo de
alelos com não africanos na análise do gráfico de mistura genética;
conseguimos incluí-los no modelo final após permitir a mistura genética
"artificial" de uma fonte relacionada à Europa (6% e 9%,
respectivamente). Também restringimos nossa análise a leituras
danificadas na determinação do haplogrupo de mtDNA para I2966. Mais
detalhes são fornecidos na Tabela Suplementar 2 e na Nota Suplementar 5 .
Parentes familiares
Buscamos
parentes próximos calculando, para cada par de indivíduos, a proporção
de alelos correspondentes (de todos os SNPs alvo) ao amostrar uma
leitura aleatória por local de cada um. Em seguida, comparamos essas
proporções com as taxas obtidas ao amostrar dois alelos do mesmo
indivíduo — espera-se que as incompatibilidades sejam duas vezes mais
comuns para indivíduos não relacionados do que para comparações dentro
do mesmo indivíduo, com parentes da mesma família apresentando taxas
intermediárias. Encontramos um possível caso entre os dois indivíduos de
White Rock Point (aproximadamente parentes de segundo grau, mas incerto
devido à baixa cobertura) (Figura Suplementar 1b ).
Conjunto de dados para análises genômicas abrangentes
Combinamos nossos dados recém-gerados com dados publicados de indivíduos antigos e atuais. 11 , 12 , 13 , 14 , 16 , 25 , 26 , 66 , 67 Realizamos
nossas análises genômicas utilizando o conjunto de SNPs autossômicos do
nosso enriquecimento alvo (cerca de 1,1 milhão).
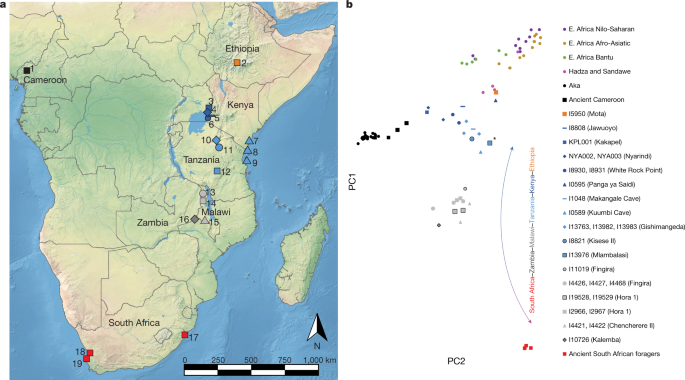
PCA
We performed a supervised PCA using the smartpca software68, using three populations (Juǀ'hoansi, Mbuti and Dinka; four individuals each, from ref. 26,
were chosen to create a broad separation in the PCA between highly
divergent ancestral lineages from southern, central and eastern Africa)
to define a two-dimensional plane of variation, and projected all other
present-day and ancient individuals (using the lsqproject and shrinkmode
options). This procedure captures the genetic structure of the
projected individuals in relation to the groups used to create the axes,
reducing the effects of population-specific genetic drift in
determining the positions of the individuals shown in the plot, as well
as bias due to missing data for the ancient individuals.
f Estatísticas
Calculamos as estatísticas f no ADMIXTOOLS. 69 ,
com erros padrão estimados por jackknife em bloco. Para facilitar o uso
de dados com baixa cobertura, utilizamos um novo programa, qpfstats
(incluído no pacote ADMIXTOOLS), juntamente com a opção 'allsnps: YES',
tanto para estatísticas f4 independentes quanto
para estatísticas para uso em qpWave e qpGraph (veja abaixo).
Resumidamente, o qpfstats resolve um sistema de equações baseado em identidades de estatísticas f
para permitir a estimativa de um conjunto consistente de estatísticas,
maximizando a cobertura disponível e reduzindo o ruído na presença de
dados faltantes; detalhes completos são fornecidos na Nota Suplementar 7 . Calculamos estatísticas da forma f 4
(Ind1, Ind2; Ref1, Ref2), onde Ind1 e Ind2 são indivíduos antigos do
Quênia, Tanzânia ou Malawi/Zâmbia, e Ref1 e Ref2 são antigos
caçadores-coletores da África Austral (AncSA, listados na Tabela de
Dados Estendidos 1
), o indivíduo Mota ou Mbuti da atualidade. Esses grupos foram
escolhidos à luz dos nossos resultados de PCA e das evidências
anteriores de ancestralidade relacionada a alguns ou a todos eles entre
antigos caçadores-coletores da África Oriental e Centro-Sul. 5 , 11 , 14 .
Análise qpWave
O software qpWave 70 A
estimativa de quantas fontes distintas de ancestralidade (de 1 até o
tamanho do conjunto de teste) são necessárias para explicar as relações
de compartilhamento de alelos entre as populações de teste especificadas
e os grupos externos (onde 'distintas' significa diferentes pontos de
divisão filogenética em relação aos grupos externos). Cada teste retorna
resultados para diferentes níveis da matriz de compartilhamento de
alelos, onde o nível k implica k + 1 fontes de ancestralidade. Para a qualidade absoluta do ajuste, fornecemos o valor P da 'cauda' , onde um valor mais alto indica um melhor ajuste. Também fornecemos os valores P
da 'diferença da cauda' como medidas relativas comparando níveis
consecutivos, onde um valor mais alto indica menor melhoria no ajuste ao
adicionar outra fonte de ancestralidade. Como nosso conjunto de teste
base, usamos os 12 indivíduos antigos de caçadores-coletores do leste e
centro-sul da África (3 do Quênia, 3 da Tanzânia, 5 do Malawi e 1 da
Zâmbia) do nosso modelo gráfico de mistura 3, que não apresentavam
evidências de mistura com produtores de alimentos ou contaminação.
Também comparamos os resultados ao adicionar o indivíduo de Mota ao
conjunto de teste. Como grupos externos, utilizamos os Neandertais de
Altai, os Mota e os seguintes oito grupos atuais: Juǀ'hoansi, ǂKhomani,
Mbuti, Aka, Iorubá, Franceses, Agaw e Aari, sendo os dois últimos (assim
como os Mota) omitidos quando transferimos os Mota para o conjunto de
teste.
Dates of admixture
Inferimos as datas de mistura genética usando o software DATES. 21 Utilizamos
uma distância genética mínima de 0,6 cM, uma máxima de 1 cM e um
tamanho de intervalo de 0,1 cM. Como populações de referência,
utilizamos antigos caçadores-coletores do sul da África juntamente com
indivíduos de uma das seguintes etnias: Mota, Dinka, Luhya, Yoruba ou
euro-americanos (os três últimos provenientes do projeto 1000 Genomes:
LWK, YRI e CEU). Os resultados assumem um intervalo médio de geração de
28 anos, e os erros padrão foram estimados pelo método jackknife em
blocos.
Ajuste do gráfico de mistura
Construímos gráficos de mistura genética usando o software qpGraph do pacote ADMIXTOOLS. 69 Optamos
por analisar cada indivíduo forrageador do leste e do centro-sul
separadamente, em vez de formar subgrupos (por exemplo, por local ou
período de tempo), para estudar a estrutura em larga e pequena escala
(por meio de relações entre indivíduos com graus de similaridade
ancestral baixos e altos). Embora essa abordagem tenha sido facilitada
pelo tamanho relativamente pequeno de nossas amostras, ela também
dependeu da capacidade de calcular as estatísticas f com nossa metodologia qpfstats (mais detalhes são fornecidos na Nota Suplementar 7 e na seção 'estatísticas f
' acima) para utilizar todos os SNPs disponíveis para indivíduos com
dados de baixa cobertura. Para todos os modelos, usamos as opções
'outpop: NULL', 'lambdascale: 1' e 'diag: 0.0001'. Também especificamos
valores maiores para o parâmetro 'initmix' para explorar o espaço de
parâmetros do grafo de forma mais completa: 100.000, 150.000 e 200.000
para os modelos 1 a 3 (e modelos adicionais construídos a partir deles),
respectivamente.
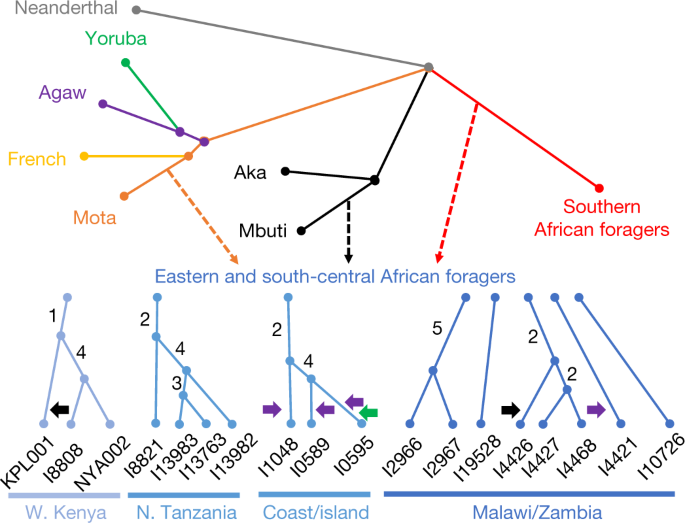
Começamos com uma versão do gráfico de mistura da ref. 16,
ao qual adicionamos três indivíduos antigos de caçadores-coletores com
alta cobertura (de Jawuoyo, Kisese II e Fingira) para criar o modelo 1.
Em seguida, expandimos nosso modelo para mais indivíduos. Utilizamos um
procedimento no qual (1) adicionamos cada indivíduo antigo, um por vez,
ao modelo 1 e avaliamos o ajuste; (2) construímos um modelo 2 de tamanho
intermediário, incluindo um total de 11 caçadores-coletores
geograficamente diversos do leste e centro-sul da África; (3)
adicionamos os indivíduos restantes, um por vez, ao modelo 2; e (4)
construímos nosso modelo final 3 com todos os 18 indivíduos acima de um
limiar de cobertura de 0,05× (Nota Suplementar 6
). Nas etapas (1) e (3), como ponto de partida, assumimos uma forma
simples de mistura (como no modelo 1), em que todos os indivíduos do
leste e centro-sul da África derivaram sua ancestralidade exatamente das
mesmas três fontes (em proporções variáveis). Caso constatássemos que
um indivíduo não se encaixava bem quando adicionado dessa maneira,
anotávamos a(s) violação(ões) específica(s) para determinar se a(s)
causa(s) provável(eis) era(m) parentesco excessivo com certos outros
indivíduos, fonte(s) distinta(s) para a mistura tripla, mistura de
outras populações, contaminação ou outros artefatos. Para os dois
indivíduos (um de Hora 1 e um de Gishimangeda) com evidências de
contaminação apreciável, incluímos eventos de mistura fictícios que
contribuíam com ancestralidade não relacionada à África. Detalhes
completos sobre nossos procedimentos de ajuste são fornecidos na Nota
Suplementar. 6 .
Análise de parentesco excessivo
To
study excess relatedness between individuals after correcting for
different proportions of Mota-related, central-African-related and
southern-African-related ancestry, we built an admixture graph similar
to our main model 3, but in which each forager individual is descended
from an independent mixture of the three ancestry components, without
accounting for excess shared genetic drift. We also included four
additional individuals with lower coverage (three from Kenya and one
from Chencherere II in Malawi), but excluded the two early individuals
from Hora 1 due to their much greater time depth compared with other
individuals in the model. Finally, for individuals modelled with
admixture beyond the primary three sources (that is, pastoralist-related
ancestry for four individuals, western-African-related ancestry for the
Panga ya Saidi individual and the excess central-African-related
ancestry for the Kakapel individual, plus dummy admixture for
contamination), we locked the relevant branch lengths and mixture
proportions at their values from model 3 to prevent compensation for the
inaccuracies in the model by these parameters. We next used the
residuals (fitted minus observed values) of each outgroup f3 A estatística (Neandertal; X, Y) quantifica o excesso de parentesco entre os
indivíduos X e Y que não é explicado pelo modelo. Em outras palavras,
ajustamos cada indivíduo como fizemos durante a fase de adição de um do
procedimento principal de inferência do grafo de mistura (exceto que
aqui todos simultaneamente), mas agora, em vez de usar as violações do
modelo para orientar a construção de um modelo com bom ajuste, usamos
essas violações diretamente como resultado da análise.
Plotamos
os resíduos de parentesco excessivo para cada par de indivíduos em
função da distância ortodrômica entre os locais, calculada usando a
fórmula de haversine (adicionando também um valor fictício de 0,001 km a
cada distância). Ajustamos curvas aos dados com a forma funcional 1/ mx , permitindo adicionalmente a translação (equação completa: y = 1/( mx + a ) + b , onde y é o parentesco excessivo, x é a distância e m , a e b
são constantes ajustadas) por meio de mínimos quadrados ponderados pela
variância inversa. Também omitimos o ponto correspondente ao par de
indivíduos de White Rock Point (Quênia) devido à evidência de parentesco
familiar próximo (ver acima). Finalmente, calculamos uma escala de
decaimento para as curvas dada pela fórmula ( e – 1) × a / m (onde e é o número de Euler). Observamos que um valor residual (isto é, no eixo y ) igual a zero não tem significado especial nos gráficos.
Para
a Europa Mesolítica, realizamos duas análises análogas, uma para a
parte ocidental do continente e outra para a parte oriental e
setentrional. Na primeira análise, selecionamos indivíduos com
ancestralidade predominantemente relacionada a caçadores-coletores
ocidentais (WHG), enquanto na segunda análise, selecionamos indivíduos
que poderiam ser modelados como tendo ancestralidade mista, tanto de WHG
quanto de caçadores-coletores orientais (EHG) (Tabela Suplementar 12
). Em ambos os casos, construímos modelos simples de grafos de mistura
para estimar os resíduos. Para a Europa Ocidental, utilizamos o
indivíduo Ust'-Ishim do Paleolítico Superior da Rússia. 71 como
grupo externo e consideramos que todos os indivíduos do teste descendem
de uma única linhagem ancestral. Para o leste e norte da Europa, usamos
Ust'-Ishim como grupo externo e Mal'ta 1 da Sibéria. 72 para um representante da ancestralidade da Eurásia setentrional antiga, Villabruna da Itália 73 para WHG, Carélia da Rússia 56 , 58 , 73 para
EHG (misturado com ancestralidade relacionada a Mal'ta e a Villabruna)
e, finalmente, os indivíduos de teste, cada um com misturas
independentes de ancestralidade relacionada a WHG e EHG em proporções
variáveis.
Inferência do tamanho efetivo da população
Realizamos
a chamada de ROH a partir da contagem de leituras para cada alelo no
conjunto de SNPs alvo (em vez de nossos dados de genótipo
pseudohaploide), que convertemos em verossimilhanças normalizadas em
escala Phred. A chamada foi feita utilizando o BCFtools/RoH. 74O
método é capaz de lidar com dados não faseados e com cobertura
relativamente baixa (pelo menos para a identificação de ROHs longos) e
não depende de um painel de haplótipos de referência. Ele também é
robusto a taxas modestas de erro de genotipagem, como as que poderiam
ocorrer neste caso devido a danos ou contaminação do DNA antigo, embora
recomendemos cautela na interpretação dos resultados para I2966 (Hora 1)
e I0589 (Caverna Kuumbi; para esta análise específica, utilizamos a
versão dos dados publicados com as bibliotecas UDG-minus incluídas,
totalizando uma cobertura média de aproximadamente 2×). Observamos ainda
que a natureza de qualquer possível efeito sobre as inferências finais é
incerta; erros podem reduzir as estimativas do tamanho populacional ao
fragmentar ROHs, mas também podem dividir ROHs muito longos em blocos
menores, porém ainda longos, que têm a maior influência nas estimativas
do tamanho populacional. Na ausência de dados em nível populacional de
grupos relacionados, especificamos uma única frequência alélica padrão
('--AF-dflt 0.4') e nenhum mapa genético (embora posteriormente tenhamos
convertido posições físicas em distâncias genéticas usando a ref. 75 ,
que esperamos ser razoavelmente precisos nas escalas de comprimento que
nos interessam). Para nossas análises, retivemos blocos ROH com
comprimento >4 cM. Em três casos, unimos blocos com uma lacuna
<0,5 cM e, no máximo, dois sítios heterozigotos aparentes entre eles.
A partir dos resultados do ROH, aplicamos a abordagem de máxima verossimilhança da ref. 23 para estimar os tamanhos populacionais efetivos ancestrais recentes ( N e
). Usamos todos os blocos de ROH com mais de 4 cM, exceto para três
indivíduos (KPL001 de Kakapel, no Quênia, I9028 de Santa Helena, África
do Sul, e I9133 de Faraoskop, África do Sul) com altas proporções de ROH
muito longos (um sinal de parentesco familiar entre os pais —
aproximadamente no nível de primos em primeiro grau nesses casos — em
vez de um tamanho populacional baixo a longo prazo), para os quais
usamos apenas blocos de 4 a 8 cM.
Observamos que, mesmo dentro de
uma população com acasalamento aleatório, o número e a extensão das
regiões de homozigose (ROH) podem variar substancialmente entre os
indivíduos, o que se reflete nos grandes erros padrão das Ne estimativas de para tamanhos de amostra pequenos. Observamos também que a mistura genética recente pode influenciar as ROH (e, portanto, Ne as estimativas de
) ao tornar a coalescência entre os dois cromossomos de um indivíduo
menos provável, mas, com base nos demais resultados do nosso estudo, não
esperamos um efeito substancial para esses indivíduos.
Resumo do relatório
Informações adicionais sobre o desenho da pesquisa estão disponíveis no Resumo do Relatório de Pesquisa da Nature, cujo link está vinculado a este artigo.